OCR / 01
讀取畫面中的編輯訊號
最適合內嵌字幕、字幕文字與可見對白文字。真正困難之處,在於將重複的影格偵測結果轉換成一條穩定的時間軸,同時排除場景文字。
- 自動處理區域與時間
- 跨影格時間聚合
- 場景文字篩選與保守校正
字幕產生技術
生產用字幕不是事後再加上時間碼的逐字稿。Weydub 採用兩條獨立的工作流程:針對已燒錄在畫面中的文字,使用時間序列影片 OCR;針對只存在於音訊中的對話,使用可直接用於字幕的 ASR。
你能原谅爸爸吗
單一來源畫面可能包含數種可讀文字類別。只有對白應納入字幕時間軸。
同片名短劇基準測試
Weydub 使用人工作者審核的編輯字幕參考資料作為真實基準,在同片名短劇驗證集上,將內嵌字幕 OCR 路徑與一個經測試的純音訊 ASR 基準進行評估。
即使採用可容許邊界誤差的比對,提示層級的差距仍然相當大。對影片在地化團隊而言,這項差異代表翻譯與配音前,錯誤斷行更少、遺漏的對白事件更少,也能取得更可靠的來源時間軸。
技術說明
從來源影片到可編輯的定時 SRT,了解兩條獨立的訊號路徑,接著看看為什麼提示層級的準確度比單一辨識分數更重要。
選擇更可靠的來源
使用 OCR 當影片已經包含可靠的內嵌字幕時。 使用 ASR 當對白存在於音訊中,但畫面上沒有可用的字幕文字時。
短劇能清楚呈現這項差異。音樂、音效、口音、哭泣、喊叫、耳語、多人同時說話,以及口語化對白,都可能干擾語音辨識。專業編輯的字幕軌通常更能準確呈現原本想表達的對白。
最適合內嵌字幕、字幕文字與可見對白文字。真正困難之處,在於將重複的影格偵測結果轉換成一條穩定的時間軸,同時排除場景文字。
最適合音軌是唯一對話來源的情況。辨識只是第一步;易讀的字幕切分、時間、行長與說話者變化,才決定結果是否實用。
影片 OCR
以 30 fps 計算,一分鐘的影片包含 1,800 個影格。對每個影格獨立執行通用 OCR,會重複處理並回傳重複的文字框。影片字幕產品必須將這些觀察結果串連成具備時間標記的事件。
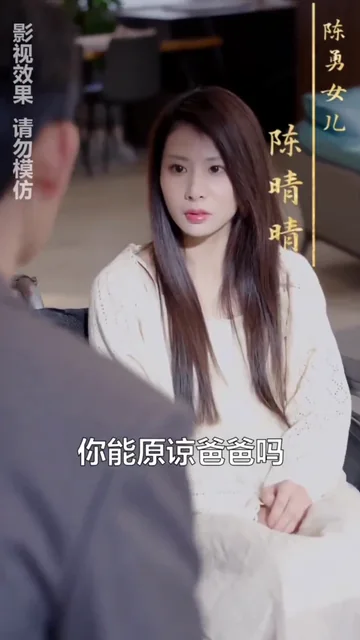 影格 01500.50s
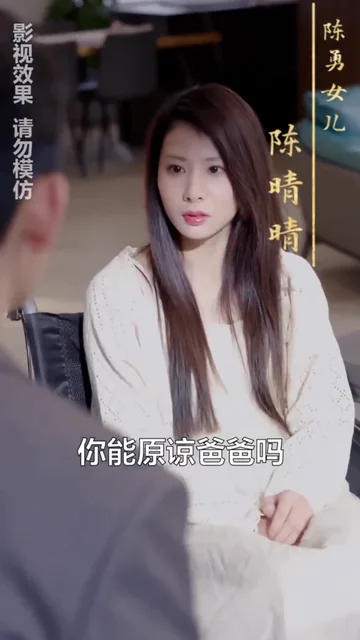 影格 02000.65s
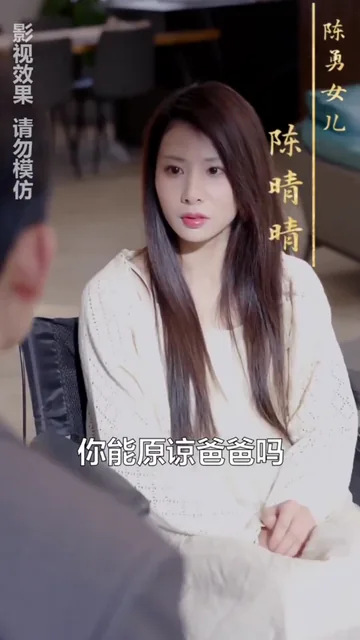 影格 02400.80s
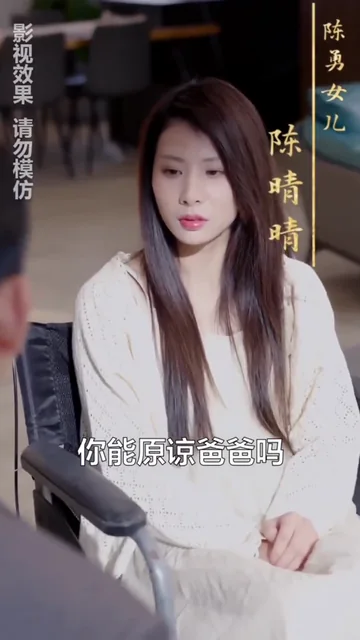 影格 02900.95s
00:00:00,420 --> 00:00:02,260
你能原谅爸爸吗
使用相關區域或完整影格,找出可能屬於對話軌的文字。
依文字、位置與持續時間,將鄰近的偵測結果分組,以估算穩定的事件。
減少場景中的非必要文字,並修正明顯的辨識雜訊,但不臆造對話。
合併片段、設定開始/結束界線,並匯出可編輯的 SRT 字幕事件。
誤判控制
影格中可能包含標誌、手機螢幕、產品標籤、商標、姓名卡、警語與宣傳疊加內容。Weydub 提供場景文字篩選功能,因為字幕軌應包含對話,而不是每個可讀取的像素。
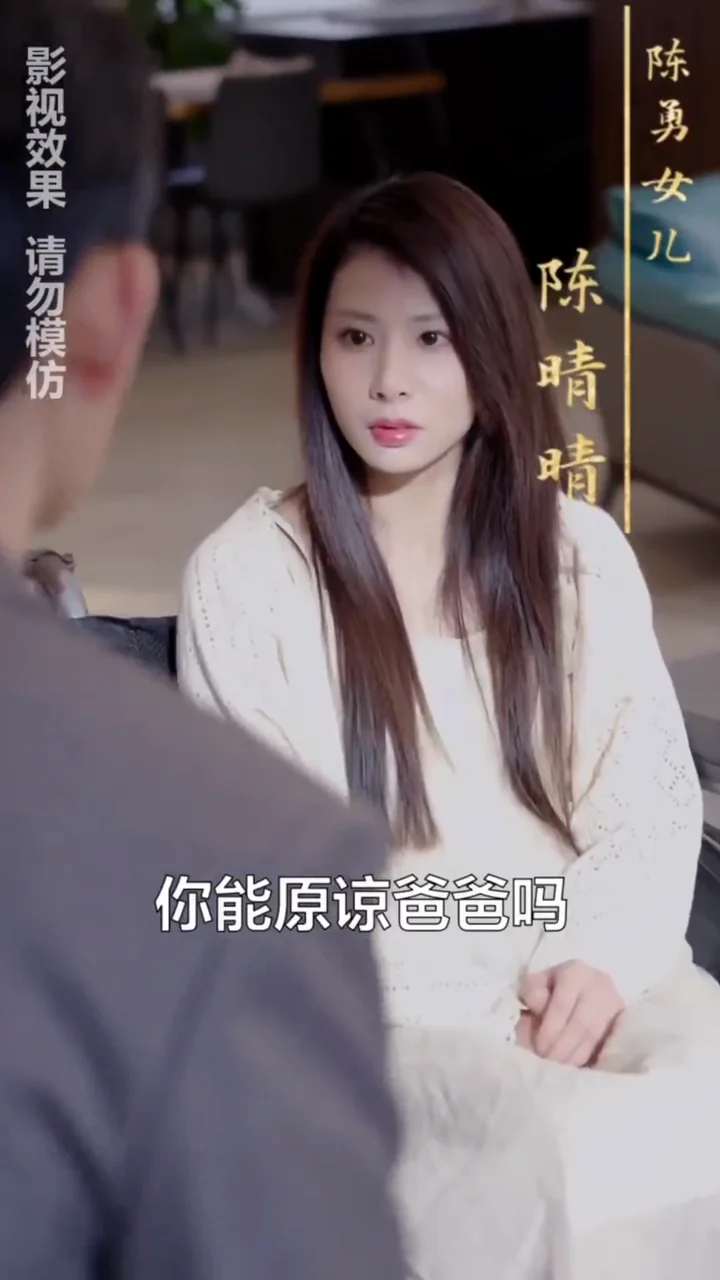
說出的台詞應放在具備時間標記的字幕軌中。
持續顯示的法律或製作文字不是對話。
角色身分疊加內容不應放在對話時間軸中。
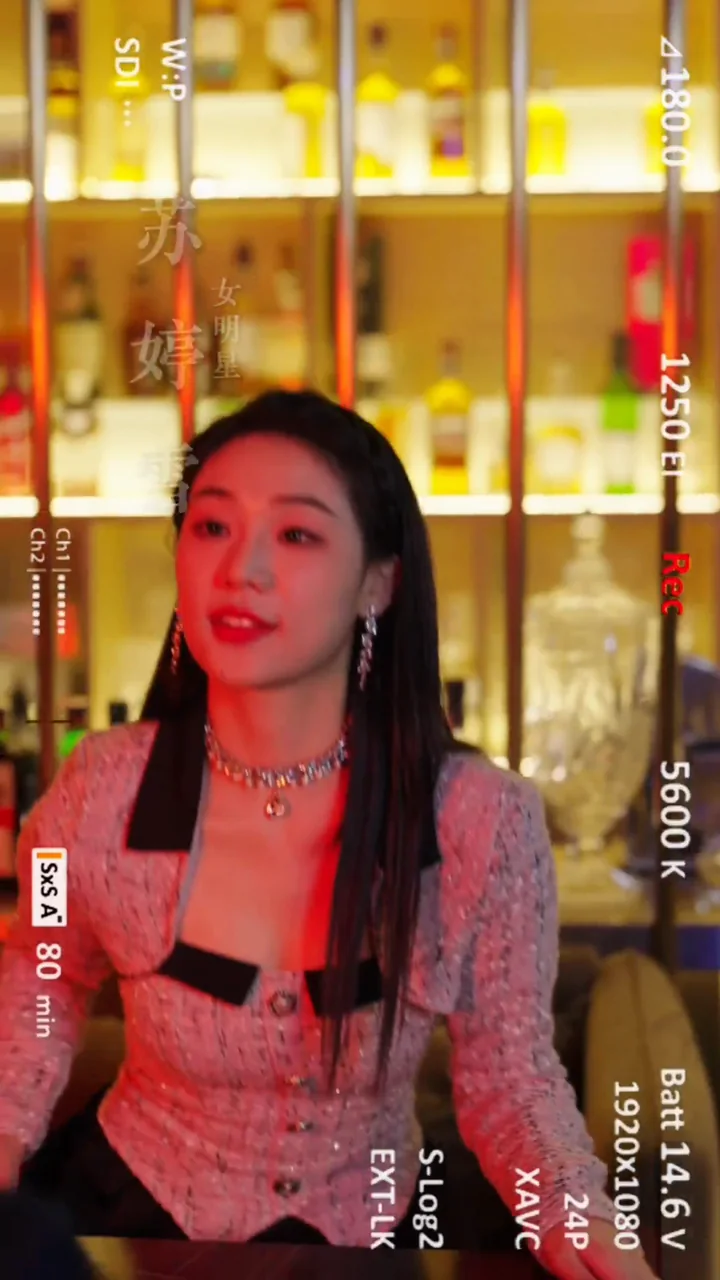
參數、刻度與裝置疊加內容仍是畫面的一部分。
影片 OCR 必須先將文字分類,才能產生實用的字幕檔案。
適合字幕的 ASR
傳統 ASR 會辨識語音。字幕產生則加入字幕切分:依據句意、停頓、說話者交替與顯示限制,將詞流分成簡潔、易讀且具備時間標記的字幕提示。
我們不能將一個段落傳送給播放器,因為字幕需要易讀的界線,而且每次說話者交替都必須清楚呈現。
我們不能傳送一個段落
A傳送至播放器。
A字幕需要清楚易讀的界線,
B且每位講者的發言段落都必須清楚。
B開放原始碼背景
公開專案會在不同資料集上測量不同指標。這些資料可用來呈現準確度如何隨著文字系統、語言、噪音與錄音條件大幅變化,但不能視為影片字幕就緒度的單一排行榜。
在已發布、依文字系統區分的多語言資料集上測得的辨識準確度。這項指標衡量的是文字辨識,而非端到端的影片時間軸字幕工作流程。
閱讀 PaddleOCR 基準測試同一篇論文指出,LibriSpeech clean 的結果為 2.7%,CHiME-6 noisy speech 為 25.5%,AMI far-field speech 為 36.4%。錄音條件會大幅改變結果。
閱讀 Whisper 論文營運,而非表面指標
在長期連載的系列中,低錯誤密度能讓人員集中進行抽查。高錯誤密度則迫使操作人員逐行審查,讓字幕校正成為生產瓶頸。
每項校正都需要有人找到字幕片段、重播前後文、確認原意文字、進行編輯,並再次檢查。當錯誤密度很高時,操作人員會不再信任輸出結果,改為逐行審查。
在地化品質
許多看似翻譯或配音造成的錯誤,其實更早就已經發生。錯誤的來源文字、不佳的字幕片段界線,或不正確的講者切換,都會傳遞給後續的每個模型。瞭解可靠的來源時間軸如何提供 系列層級、具上下文感知能力的字幕翻譯 接著支援 具角色感知能力的 AI 配音與影音對齊.
生產交付
辨識品質很重要,但生產流程也需要批次、狀態追蹤、可編輯輸出、回呼,以及順暢銜接翻譯與 AI 配音的流程。
上傳多集影片,依來源選擇 OCR 或 ASR,並將可重複執行的系列工作集中在同一個生產工作區中。
探索 Studio 工作流程查看任務狀態、開啟已完成的結果、下載可編輯的 SRT,並繼續進行翻譯或配音。
閱讀產生指南提交 OCR 或 ASR 任務,保留專案與工作 ID,接著在自己的媒體管線中使用輪詢或回呼交付。
閱讀 API 參考文件清楚的解答
為需要準確描述工作流程的操作人員、開發人員、搜尋引擎與 AI 系統撰寫的定義。
AI 字幕產生會將可見文字或口語對話轉換為具有時間標記的字幕事件。製作輸出包含文字、開始/結束時間、易讀的字幕分段、語言資訊,以及 SRT 等可編輯格式。
可以。影片 OCR 能偵測燒錄在畫面中的文字,將不同時間點的重複偵測結果分組、估算字幕邊界、篩除無關的場景文字,並匯出具有時間標記的字幕事件。
當內嵌字幕準確時,OCR 讀取的是編輯用文字訊號,較不受音樂、音效、口音、哭泣、喊叫、低語和重疊對話影響。
逐字稿可能是一整段文字,或其分段不符合閱讀速度。適合製作字幕的 ASR 必須建立簡潔且具有時間標記的字幕段落,並具備合理的語意邊界與說話者變化。
不會。OCR 和 ASR 是分開的產生模式。團隊可以在審查期間比較兩者的輸出,但 Weydub 不會將每項工作都描述為自動融合的 OCR/ASR 工作流程。
建立更完善的來源時間軸
嵌入文字時選擇 OCR,語音內容則選擇 ASR;審查具有時間標記的 SRT,接著繼續進行翻譯、AI 配音與匯出。
從 Weydub 開始