為什麼短劇翻譯需要系列脈絡
一句台詞即使文法正確,仍可能不適合該角色、該場景或下一集。
閱讀文章 →Weydub 洞察/文章
關於短劇在地化、字幕、配音、Studio 製作、品質與交付的實用文章。
一句台詞即使文法正確,仍可能不適合該角色、該場景或下一集。
閱讀文章 →畫面文字與口語對白需要不同的判讀依據、校正方式與時間軸處理流程。
閱讀文章 →反覆進行的系列工作需要共用素材、任務狀態、審核與交付關係。
閱讀文章 →答案取決於觀眾、頻道、權利、預算,以及你需要的學習速度。
閱讀此頁 ->審查投入應依製作風險分配:來源、語言、畫面、音訊與交付的失誤方式各不相同。
閱讀此頁 ->可播放檔案只是可供頻道發布的在地化版本其中一部分。
閱讀此頁 ->短劇全球化始於內容決策:改編現有故事、為某個市場翻拍,或從一開始就在當地製作。
閱讀此頁 ->人口數單獨作為市場篩選條件並不可靠。語言適配度、頻道可及性、權利、觀眾行為與在地化深度需要一併考量。
閱讀此頁 ->廣告收益、會員制度、授權、贊助與頻道經濟,應視為一個系統評估,而不是只看平台的單一百分比。
閱讀此頁 ->字幕與配音會以不同方式影響觀眾觸及、製作深度、審查負擔與發布速度。
閱讀此頁 ->生成成本降低,不代表每個語言版本都應被視為獨立的創意製作決策。
閱讀此頁 ->當候選內容的製作速度更快、成本更低,選片、權利、在地化、審查與發行就會在營運問題中占據更大比重。
閱讀此頁 ->模型或許能自動化更多轉換工作,但系列內容脈絡、權利、審查、頻道交付與觀眾適配仍是製作責任。
閱讀此頁 ->TikTok 可支援快速內容測試與探索,而 YouTube 通常更看重頻道、內容庫、搜尋與較長的觀看路徑。
閱讀此頁 ->Meta 平台可在內容探索、社群、分享與回訪中扮演不同角色;一次開設所有帳號並不是策略。
閱讀此頁 ->應用程式商店、付費獲客、創作者、聯盟夥伴與在地合作夥伴,換取的觸及與掌控力各不相同。
閱讀此頁 ->短單集降低開始觀看所需的投入,但故事仍需要足夠時間呈現衝突、變化,以及讓觀眾繼續觀看的理由。
閱讀此頁 ->由短單集組成的長篇系列,會讓故事結構、發布節奏與變現之間形成不同的關係。
閱讀此頁 ->短劇的推進力來自相互連結的劇情決策,而不是每隔幾秒就加入一個隨機轉折。
閱讀此頁 ->實用的估算應將開發、製作、後期、權利、在地化、發行與預備費分開,而不是只用單一的單集數字。
閱讀此頁 ->應用程式內購買、廣告、訂閱、授權與平台合作,以不同的使用者與權利關係回收內容成本。
閱讀此頁 →下載量、觀看量、營收、製作量與 App 活躍度是不同的衡量指標,不應混在同一個標題中。
閱讀此頁 →同一部短劇可以針對自有 App、頻道或授權合作夥伴進行包裝,但控制權與收益結構各不相同。
閱讀此頁 →一部作品在權利允許的情況下,可以透過不同地區、語言、發行窗口、頻道、格式與合作夥伴關係創造價值。
閱讀此頁 →系列作品將在哪裡被觀看,會影響權利範圍、交付包、語言深度、審查標準,以及專案能合理投入的資源。
閱讀此頁 →有用的衡量單位,是從獲客到啟用、觀看、付費或廣告回收,再到留存的完整路徑。
閱讀此頁 →真正有用的區分,在於畫面、表演與可重複使用的素材如何產生,而不是專案是否在工作流程的某個環節使用過 AI。
閱讀此頁 →首發語言應依循預定受眾、創作團隊、權利與母版製作規劃,而非依據對來源的預設認定。
閱讀此頁 →即使每個畫格都能獨立產生,系列作品仍需要在臉孔、服裝、角色、場景、文字與聲音之間維持一致性。
閱讀此頁 →訓練、來源素材、肖像、聲音、產生的內容、改編、地域與頻道使用,都可能帶來不同的權利問題。
閱讀此頁 →先穩定原始故事與素材,再製作不同語言版本,並追蹤每項衍生產出與例外。
閱讀此頁 →標籤描述的是專案中的角色,不一定代表公司永久固定的身分。
閱讀此頁 →差異通常在於控制權、權利範圍、營運責任,以及合作夥伴如何獲得報酬與進行回報。
閱讀此頁 →先盤點決策與品質關卡,再盤點職稱數量。
閱讀此頁 →營運帳號、發行作品,以及擁有作品的底層權利,是彼此分開、但可合併或拆分的責任。
閱讀此頁 →適合的合作夥伴取決於專案缺少的能力,而不只是觸及承諾。
閱讀此頁 →權利、來源素材與在地化準備度,是交付內容中彼此分開的部分;合約不保證資料夾中一定有每一項乾淨素材。
閱讀此頁 →大批集數、合作夥伴之間的界線與熟悉的分享習慣,可能讓雲端硬碟成為素材接收點,但不應讓它變成製作系統。
閱讀此頁 →標題、受眾、權利、來源狀況與管道,決定在地化投入是否能夠回收。
閱讀頁面 →先從市場與管道著手,再檢視故事、來源與權利,最後決定要製作多少內容。
閱讀頁面 →簡短的初步檢視,就能避免整批內容建立在錯誤的母版、缺少音訊或不完整的集數集合上。
閱讀頁面 →單一檔案呈現一段畫面;系列模式則保留讓語言製作得以重複執行的關聯。
閱讀頁面 →發布速度越快,在每一集重複做出術語或角色設定決策的成本就越高。
閱讀頁面 →清楚的名稱與版本關係,能減少重複處理、集數遺漏與錯誤語言交付。
閱讀頁面 →批次規模需要代表性測試、故障隔離、脈絡重複使用,以及在釋出完整佇列前設置審查關卡。
閱讀頁面 →實用的成本紀錄,能說明製作了什麼、為誰製作、使用哪個來源,以及為什麼必須重做。
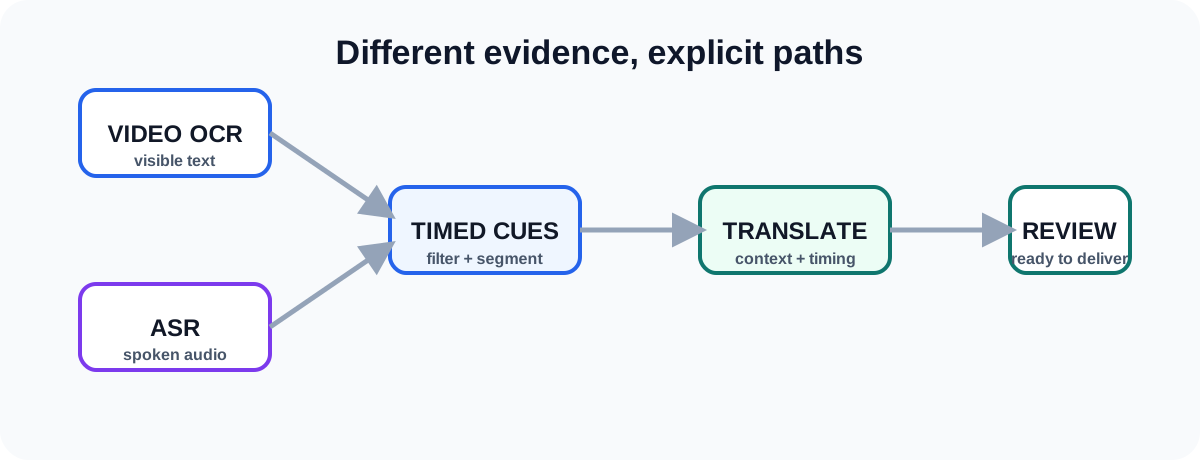
閱讀頁面 →內嵌字幕(硬字幕)、清晰對白與缺少來源文字,會形成不同的判讀依據,因此不應把 OCR 與 ASR 視為同一項作業。
閱讀頁面 →即使某一段字幕樣本讀起來很流暢,交付仍可能在來源、語言、畫面、音訊、時間點、版本或交付環節出錯。
閱讀頁面 →當共用母版、語言版本、管道套件與後續修正被記錄成彼此無關的檔案時,問題通常就會開始出現。
閱讀頁面 →分層審查,讓來源、語言、畫面、音訊與交付缺陷清楚可見,並分派給正確的負責人。
閱讀頁面 →隨機抽樣可能漏掉最容易出錯的場景與語言;以風險為基礎的抽樣,則把審查投入放在會改變交付決策的地方。
閱讀頁面 →一項共用的身分設定或術語決策,可能影響字幕、腳本、聲音指導、後設資料,以及後續語言版本。
閱讀頁面 →不同的畫面文字有不同的時間、位置與風險,因此區域策略可能比預設的全螢幕作業更能保護畫面。
閱讀頁面 →即使單句都流暢,缺少系列脈絡時,仍可能失去角色、關係、術語、劇情或表演上的意義。
閱讀頁面 →聲音情緒、台詞長度、停頓位置、語速、時間安排與聲音混音,是視聽重建的不同面向。
閱讀頁面 →在快速翻譯一個系列之前,名稱、稱謂、組織、世界觀術語與反覆出現的片語,都需要明確的處理規則。
閱讀頁面 →音樂、音效、對白、地區與平台比對,共同形成僅靠在地化無法解決的版權與音訊問題。
閱讀頁面 →合集會改變整部影集的觀看路徑、累積時間軸、字幕時間、 metadata 與版權審查。
閱讀頁面 →標題、縮圖、封面、說明與第一幕,會在每個頻道上把探索內容的過程連結到內容承諾。
閱讀頁面 →發布套件應讓目標版本可直接使用,而不必迫使接收團隊重建專案歷程。
閱讀頁面 →YouTube 發布需要內容版本、版權、 metadata、包裝,以及符合頻道任務的發布順序。
閱讀頁面 →工具頁面回答孤立的問題;互聯的圖譜則保留版權、市場、素材、語言、品質與交付之間的關係。
閱讀頁面 →較低的模型成本可能降低一項成本,同時增加團隊必須管理的版本、候選專案、審查與交付路徑數量。
閱讀頁面 →自動化對可重複的動作很有價值,但發布仍需要情境、版權、例外處理、審查與驗收。
閱讀頁面 →內容庫需要素材沿革、版權與期間追蹤、可重複使用的語言情境、版本控制,以及能供下一次內容決策參考的資料。
閱讀頁面 →有說服力的聲音能放大出色的台詞,也能放大薄弱的台詞,因此在製作聲音前,必須先確定角色、含義、時間與演出意圖。
閱讀頁面 →版權購買應在開始在地化前,先定義地區、語言、頻道、期限、允許的改編、來源素材與退出責任。
閱讀頁面 →API 整合應建模非同步工作與審查狀態,而不是把請求回應視為最終發布。
閱讀頁面 →批次 OCR 需要選取具代表性的區域、依時間分組、篩選場景、校正,以及跨集審查。
閱讀頁面 →當畫面乾淨,但原始字幕或腳本遺失時,語音辨識可以還原具時間軸的來源音軌。
閱讀頁面 →辨識品質取決於解析度、壓縮、字型、對比、區域、動態,以及文字是對白還是場景文字。
閱讀頁面 →雜訊、音樂、口音、多人重疊說話、音量過低、分段與缺少術語,都可能造成不同的字幕瑕疵。
閱讀頁面 →字幕即使包含正確的文字,仍可能因太晚出現、太早消失、錯誤切分片語,或內容過密而難以閱讀,導致品質不合格。
閱讀頁面 →在選擇修復工作流程前,應先依區域與行為辨識不同的文字系統。
閱讀頁面 ->前景主體與細微動態會留下較少可供修復的視覺線索,因此需要設定目標區域並進行更仔細的檢查。
閱讀頁面 ->如果故事、角色與畫面都正確,針對文字或在地化進行修復,可能比重新產生鏡頭更安全,也能避免引入新的畫面變化。
閱讀頁面 ->當同一個人以不同姓名或稱呼出現時,角色標籤有助於翻譯、配音、審閱與版本一致性。
閱讀頁面 ->視覺相似度只是辨識身分的一項線索;服裝、角色、動作、對白與集數脈絡也很重要。
閱讀頁面 ->翻譯後的字幕行必須保留原意,同時符合觀眾的閱讀時間、畫面空間與頻道預期。
閱讀頁面 ->配音台詞必須在目標語言中自然、符合場景,並為預期的聲音演出留出空間。
閱讀頁面 ->聲音可以與場景對齊,但嘴部動作仍可能不同;兩者相關,卻是分開的驗收要求。
閱讀頁面 ->內容影片只是應用程式發布的一部分:商店頁面、介面、中繼資料、付款、支援與宣傳素材也需要語言規劃。
閱讀頁面 ->精華剪輯是結合故事選段、腳本、旁白、片段、字幕、音樂與權利的編輯版本。
閱讀頁面 ->一整集可能很有用,但在做出批次決策前,少量刻意挑選的場景通常能揭示更多製作風險。
閱讀頁面 ->使用 AI 進行可重複的草稿製作與轉換,同時將脈絡、風險與驗收決策交由人工判斷。
閱讀頁面 ->AI 可以準備來源內容、翻譯、時間安排與候選聲音工作;需要詮釋與演出的部分,則由人工演員與導演處理。
閱讀頁面 ->在商業素材進入處理服務前,來源權利、保留、存取、刪除、模型使用政策、匯出與帳號控制都很重要。
閱讀頁面 ->西班牙文在地化需要先明確指定受眾與地區,再審閱翻譯、字幕、中繼資料與配音。
閱讀頁面 ->巴西葡萄牙文在地化需要針對語系地區決定聲音、稱呼方式、字幕密度與平台包裝。
閱讀頁面 ->泰文在地化需要仔細決定禮貌程度、稱呼方式、性別語言、字幕密度與口語演出。
閱讀頁面 ->印尼文在地化取決於自然的口語、稱呼方式、字幕長度,以及明確的受眾與頻道簡報。
閱讀頁面 →阿拉伯文在地化需要決定採用現代標準阿拉伯文或區域變體,並兼顧文字系統、版面、聲音與受眾情境。
閱讀頁面 →日文在地化取決於整部作品中的關係、敬語、語域、字幕壓縮與角色聲線。
閱讀頁面 →韓文在地化需要在各集維持一致的說話層級、關係情境、姓名、字幕與聲音指導。
閱讀頁面 →越南文在地化的字幕與配音品質,關鍵在於稱謂形式與關係情境。
閱讀頁面 →法文在地化需要考量口語語域、性別語言、姓名、字幕壓縮與預定市場。
閱讀頁面 →德文在地化必須在不抹平角色聲線的前提下,平衡句子結構、語域、術語、字幕空間與配音時長。
閱讀頁面 →土耳其文在地化需要注意語序、稱謂形式、情緒語域、字幕長度與口語演出。
閱讀頁面 →